Informatyka
Wielkie modele językowe (LLM)
Zestaw wyjaśnia budowę, uczenie i działanie wielkich modeli językowych, ze szczególnym uwzględnieniem architektury Transformer, tokenizacji, pretrainingu i dostrajania. Omawia także generowanie tekstu, metody ewaluacji, zastosowania, ograniczenia oraz zagadnienia bezpieczeństwa i alignmentu.
Podcast
Ładuję…
1.LLM (Large Language Model)
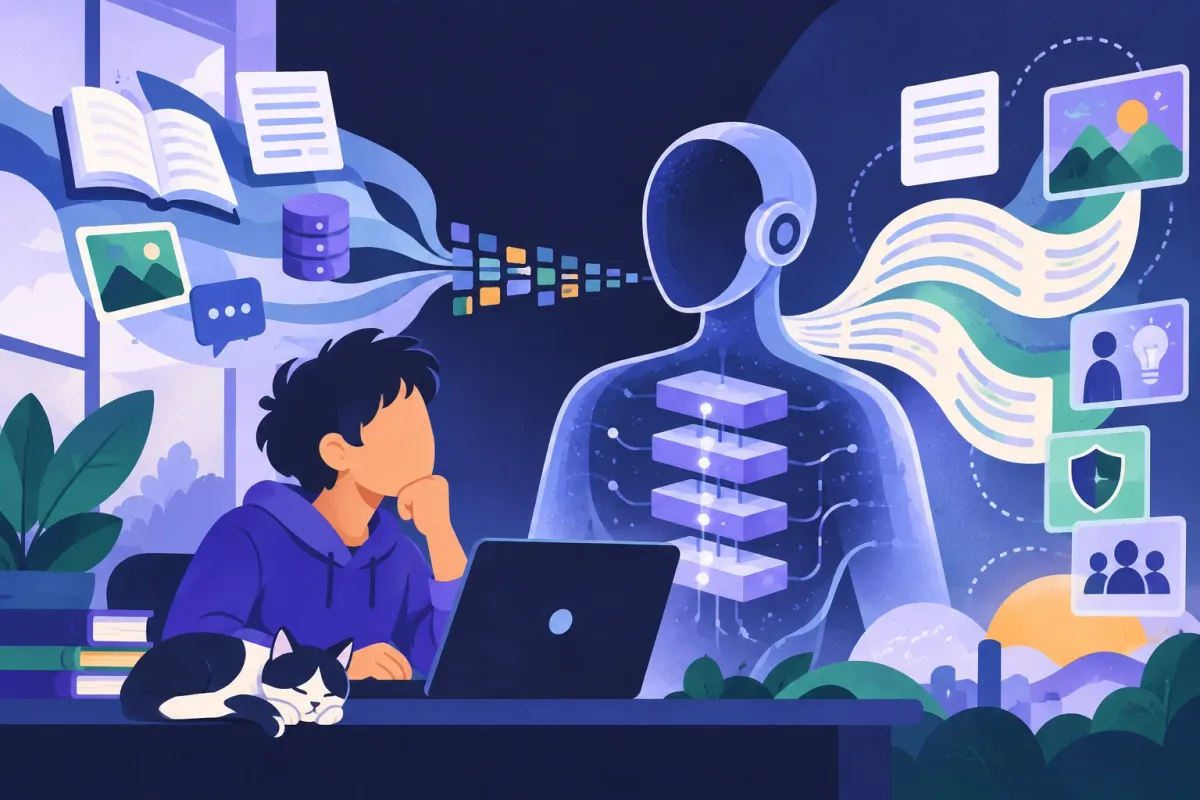
Wielki model językowy to model uczenia maszynowego, zwykle oparty na architekturze Transformer, wytrenowany na dużych zbiorach tekstu w celu modelowania zależności między tokenami i generowania tekstu.
2.Model autoregresyjny
Model, który przewiduje kolejny token na podstawie tokenów poprzedzających go w sekwencji. Generowanie odbywa się iteracyjnie: przewidziany token staje się częścią kontekstu dla następnego kroku.
3.Token
Jednostka wejścia modelu, niekoniecznie odpowiadająca słowu. Tokenem może być całe słowo, jego fragment, znak interpunkcyjny lub fragment kodu.
4.Tokenizacja
Proces zamiany tekstu na sekwencję tokenów, a następnie na odpowiadające im identyfikatory liczbowe. Sposób tokenizacji wpływa na długość kontekstu, koszt i jakość modelu.
5.Słownik tokenów
Zbiór tokenów rozpoznawanych przez model wraz z przypisanymi im identyfikatorami. Rozmiar słownika stanowi kompromis między długością sekwencji a liczbą możliwych reprezentacji.
6.Embedding
Wektorowa reprezentacja tokenu, pozycji lub innego obiektu, uczona tak, aby kodować informacje użyteczne dla modelu. Embeddingi są elementami przestrzeni numerycznej używanymi w obliczeniach sieci.
7.Transformer
Architektura sieci neuronowej wykorzystująca przede wszystkim mechanizm self-attention oraz warstwy feed-forward. Umożliwia efektywne przetwarzanie zależności między elementami sekwencji.
8.Self-attention
Mechanizm wyznaczający, jak silnie każdy token powinien uwzględniać inne tokeny w bieżącej sekwencji. Pozwala modelowi tworzyć kontekstową reprezentację tokenów.
9.Query, key, value
W self-attention każdy stan jest przekształcany do wektorów query, key i value. Podobieństwo query do key określa wagi uwagi, a ważona suma value tworzy wynik mechanizmu.
10.Causal attention
Odmiana self-attention z maską uniemożliwiającą tokenowi korzystanie z przyszłych tokenów. Jest niezbędna w autoregresyjnym generowaniu, aby zachować porządek przyczynowy.
11.Pozycjonowanie tokenów
Informacja o kolejności tokenów dodawana do ich reprezentacji, ponieważ podstawowy mechanizm attention sam w sobie nie koduje porządku sekwencji. Stosuje się m.in. embeddingi pozycyjne lub metody rotacyjne.
12.Kontekst i okno kontekstowe
Kontekst to tokeny dostępne modelowi podczas obliczania odpowiedzi. Okno kontekstowe oznacza maksymalną liczbę tokenów, które model może jednocześnie uwzględnić.
13.Pretraining
Wstępne uczenie na ogromnym, zróżnicowanym korpusie, zwykle z celem przewidywania brakujących lub kolejnych tokenów. Model zdobywa wówczas ogólne reprezentacje języka i danych.
14.Loss językowy
Funkcja straty mierząca różnicę między rozkładem przewidywanym przez model a tokenem docelowym. W typowym pretrainingu stosuje się entropię krzyżową (cross-entropy) dla następnego tokenu.
15.Fine-tuning
Dalsze uczenie wcześniej wytrenowanego modelu na mniejszym, wyspecjalizowanym zbiorze danych. Może dostosować model do domeny, stylu, zadania lub formatu odpowiedzi.
16.Instruction tuning
Dostrajanie na parach lub przykładach przedstawiających polecenia i pożądane odpowiedzi. Uczy model lepiej interpretować intencje użytkownika i wykonywać zadania w formie instrukcji.
17.RLHF
Reinforcement Learning from Human Feedback: metoda wykorzystująca ludzkie oceny odpowiedzi do uczenia modelu nagrody, a następnie optymalizowania zachowania modelu względem tej nagrody.
18.DPO
Direct Preference Optimization to metoda dostrajania na parach odpowiedzi preferowanej i odrzuconej, która optymalizuje preferencje bez osobnego, klasycznego etapu uczenia modelu nagrody.
19.Temperatura generowania
Parametr modyfikujący ostrość rozkładu prawdopodobieństwa kolejnych tokenów. Niższa temperatura zwykle sprzyja deterministycznym odpowiedziom, a wyższa zwiększa różnorodność i ryzyko przypadkowych wyborów.
20.Top-p sampling
Strategia próbkowania, w której model wybiera kolejny token spośród najmniejszego zbioru tokenów o łącznym prawdopodobieństwie co najmniej p. Ogranicza wybór do najbardziej prawdopodobnej części rozkładu.
21.Halucynacja modelu
Wygenerowana treść, która brzmi wiarygodnie, lecz jest fałszywa, nieuzasadniona lub niezgodna ze źródłami. Wynika m.in. z optymalizacji płynności i prawdopodobieństwa, a nie bezpośrednio prawdziwości.
22.RAG
Retrieval-Augmented Generation: podejście, w którym system najpierw wyszukuje istotne dokumenty lub fragmenty, a następnie przekazuje je modelowi jako kontekst do wygenerowania odpowiedzi.
23.Parametry modelu
Wartości liczbowe uczone podczas treningu, które określają funkcję modelu. Liczba parametrów jest ważnym wskaźnikiem skali, lecz sama nie przesądza o jakości ani użyteczności.
24.Hiperparametr
Ustalona przez projektanta wartość procesu uczenia, architektury lub generowania, np. współczynnik uczenia, rozmiar partii, liczba warstw albo temperatura generowania.
25.Transfer learning
Wykorzystanie wiedzy nabytej przez model w jednym zadaniu lub domenie do rozwiązywania innych zadań. Pretraining LLM jest szczególnym, szeroko stosowanym przypadkiem transferu.
26.Emergent abilities
Zdolności obserwowane jako pojawiające się lub gwałtownie poprawiające przy zwiększaniu skali modelu. Ich status jest dyskutowany, ponieważ część efektów może wynikać z metryk i sposobu ewaluacji.
Notatka
Istota i poziomy opisu LLM
Wielki model językowy, czyli , jest parametrycznym modelem uczenia maszynowego przeznaczonym do modelowania sekwencji językowych. W praktyce najczęściej jest to model , którego parametry są uczone na bardzo dużych zbiorach tekstu, kodu lub danych multimodalnych.
Model nie operuje bezpośrednio na znaczeniu zdań w sensie symbolicznym. Tekst przechodzi przez , a tokeny są zamieniane na identyfikatory i reprezentacje wektorowe. Następnie sieć przekształca te reprezentacje w kontekstowe stany, z których wyznacza prawdopodobieństwa kolejnych tokenów.
- dane: korpus tekstów, kodu lub innych modalności
- architektura: warstwy Transformer
- parametry: uczone wartości liczbowe sieci
- inferencja: użycie wytrenowanego modelu do wygenerowania wyniku
Ważne
LLM jest przede wszystkim modelem rozkładu prawdopodobieństwa nad sekwencjami tokenów; płynność odpowiedzi nie stanowi sama w sobie dowodu jej prawdziwości.
Tokenizacja, embeddingi i kontekst
Tokenizacja dzieli tekst na jednostki dobrane przez tokenizer. W zależności od algorytmu może odpowiadać całemu słowu, fragmentowi słowa, znakowi interpunkcyjnemu albo elementowi kodu. Popularne podejścia wykorzystują podział na często występujące podciągi, dzięki czemu słownik nie musi zawierać każdego możliwego słowa.
Identyfikator tokenu jest następnie mapowany na , czyli wektor liczb. Do reprezentacji dodaje się informację o pozycji tokenu, ponieważ zwykły mechanizm attention nie koduje kolejności w sposób wystarczający. Rezultatem jest sekwencja wektorów przetwarzana przez kolejne warstwy.
Okno kontekstowe określa maksymalną liczbę tokenów dostępnych w danym przebiegu. Obejmuje ono zazwyczaj instrukcję, historię rozmowy, dokumenty dostarczone przez i miejsce na odpowiedź. Dłuższy kontekst zwiększa możliwości systemu, ale także wymagania pamięciowe i obliczeniowe.
Przykład
Jedno rzadkie lub długie słowo może zostać podzielone na kilka tokenów, dlatego liczba słów w tekście nie jest tym samym co liczba tokenów.
Architektura Transformer
Transformer składa się z powtarzających się bloków, w których kluczową rolę odgrywa oraz warstwa feed-forward, często nazywana także MLP. W self-attention stany tokenów są przekształcane do wektorów query, key i value. Podobieństwo query do key wyznacza wagi, a ważona agregacja value tworzy informację kontekstową.
W modelu autoregresyjnym stosuje się maskę przyczynową. Token może korzystać z tokenów wcześniejszych, ale nie z przyszłych, których podczas generowania jeszcze nie ma. Dzięki temu proces uczenia odpowiada późniejszej generacji lewostronnej.
Ważne elementy praktycznych Transformerów obejmują także normalizację, połączenia rezydualne, funkcje aktywacji, warstwy wyjściowe oraz sposób kodowania pozycji. Warianty architektury różnią się m.in. tym, czy są encoder-only, decoder-only czy encoder-decoder.
- encoder-only: często używany do reprezentacji i klasyfikacji
- decoder-only: typowy dla autoregresyjnego generowania tekstu
- encoder-decoder: przydatny w zadaniach transformacji sekwencji
Zapamiętaj
jest mechanizmem zapewniającym, że model generujący kolejny token nie wykorzystuje informacji z przyszłości.
Uczenie: pretraining i dostrajanie
W pretrainingu model otrzymuje ogromny korpus i uczy się przewidywać token docelowy na podstawie kontekstu. Dla modelu autoregresyjnego typowym zadaniem jest next-token prediction, a funkcją straty jest zwykle entropia krzyżowa (cross-entropy). W treningu stosuje się wiele iteracji optymalizacji, partie danych oraz rozproszone obliczenia na akceleratorach.
Po pretrainingu model może być dostrajany. na danych domenowych poprawia działanie w określonym obszarze, natomiast uczy reagowania na polecenia. W praktyce stosuje się również dostrajanie preferencyjne, np. RLHF albo DPO, aby zwiększyć użyteczność, zgodność z instrukcjami i bezpieczeństwo.
Skala modelu nie jest jedynym czynnikiem jakości. Znaczenie mają również jakość i różnorodność danych, budżet obliczeniowy, architektura, optymalizacja, długość treningu oraz procedury ewaluacyjne. Hiperparametry są ustalane przez projektanta, podczas gdy są uczone.
Ważne
uczy ogólnych zależności, ale nie gwarantuje, że model będzie pomocny, bezpieczny, aktualny ani zgodny z oczekiwaniami użytkownika.
Generowanie i systemy rozszerzone
Podczas inferencji model oblicza rozkład prawdopodobieństwa następnego tokenu. Token może zostać wybrany deterministycznie, np. przez wybór tokenu o największym prawdopodobieństwie, albo losowany z kontrolowanego rozkładu. Temperatura wpływa na ostrość tego rozkładu, a top-p ogranicza wybór do najmniejszego zbioru tokenów obejmującego określoną masę prawdopodobieństwa.
Prompt engineering polega na projektowaniu instrukcji, kontekstu, przykładów i formatu odpowiedzi. Nie zmienia parametrów modelu. Fine-tuning zmienia parametry poprzez dodatkowe uczenie, natomiast RAG dostarcza modelowi informacje pobrane z zewnętrznych źródeł bez konieczności zapisywania całej tej wiedzy w wagach.
System RAG zwykle obejmuje przygotowanie dokumentów, ich podział na fragmenty, utworzenie reprezentacji wektorowych, wyszukanie podobnych fragmentów i przekazanie ich do modelu jako kontekstu. Jakość odpowiedzi zależy więc także od wyszukiwarki, jakości dokumentów i sposobu cytowania źródeł.
- deterministyczność i różnorodność kontroluje się parametrami dekodowania
- aktualność można poprawić przez wyszukiwanie i narzędzia
- format można wymuszać instrukcją lub ograniczeniami dekodowania
Ewaluacja, ograniczenia i bezpieczeństwo
Ewaluacja LLM powinna obejmować więcej niż jedną metrykę. Perplexity mierzy jakość predykcji tokenów, ale nie ocenia w pełni użyteczności dialogu, zgodności z instrukcją, prawdziwości, bezpieczeństwa ani odporności na ataki. Stosuje się benchmarki zadaniowe, testy eksperckie, ocenę ludzką, porównania preferencji i testy red-teamowe.
Najważniejsze ograniczenia to halucynacje, uprzedzenia wynikające z danych, podatność na prompt injection, wrażliwość na zmianę sformułowania, ograniczenia okna kontekstowego oraz możliwe ujawnianie danych. Model może także reprodukować treści z danych treningowych lub generować kod i porady obarczone błędami.
W zastosowaniach wysokiego ryzyka konieczne są kontrola człowieka, walidacja źródeł, ograniczenie zakresu działania, logowanie i testy regresji. W systemach narzędziowych należy dodatkowo kontrolować uprawnienia agenta, dane wejściowe i skutki wykonywanych działań.
Zapamiętaj
Bezpieczeństwo systemu zależy nie tylko od samego modelu, lecz także od danych, promptów, narzędzi, uprawnień, monitoringu i procedur organizacyjnych.
W skrócie
- 03Causal attention jest mechanizmem zapewniającym, że model generujący kolejny token nie wykorzystuje informacji z przyszłości.
- 06Bezpieczeństwo systemu zależy nie tylko od samego modelu, lecz także od danych, promptów, narzędzi, uprawnień, monitoringu i procedur organizacyjnych.
Pojęcia z fiszek
Quizy w tym zestawie
38 pytań w 4 etapach
Etap 1: Podstawy i reprezentacja tekstu
Etap 1 · 5 fiszek · 5 pytań
Etap 2: Architektura i mechanizm uwagi
Etap 2 · 7 fiszek · 6 pytań
Etap 3: Uczenie i ocena modeli
Etap 3 · 9 fiszek · 14 pytań
Etap 4: Generowanie i zastosowania LLM
Etap 4 · 5 fiszek · 13 pytań
Powtórka z całości
15 pytań ze wszystkich etapów, po ukończeniu etapów
Sprawdzian do druku
Arkusz PDF z kluczem, punktacją i oceną
Sprawdzam sprawdzian…
Znasz kogoś z klasy, komu się przyda? Podziel się zestawem
Podobne zestawy
 Działanie komputera, zapis danych i bezpieczna praca
30 fiszek uczy się 1
 Internet: usługi, chmura, wyszukiwanie i bezpieczeństwo
40 fiszek uczy się 2
 Sieci komputerowe i internet
38 fiszek uczy się 1
 Podstawy i parametry sieci komputerowych
24 fiszki uczy się 5
 Wojewódzki Konkurs Przedmiotowy z Informatyki (śląskie) - algorytmy i dane
40 fiszek uczy się 39
 Python: instrukcje warunkowe
12 fiszek uczy się 8
Wyszukiwarka
Szukasz czegoś innego?
Wpisz temat, dział albo tytuł podręcznika i znajdź gotowy zestaw.